中國網/中國發展門交流戶網訊 近年來,人工智能(AI)正在加快融進醫療安康相關研討中。醫院是我國醫療安康領域主要的人工智能研討基地與產出基地。今朝,對醫院主導人工智能研討現狀調查尚不充足。部門關于醫院人工智能的研討僅強調了內部資源局限和一些常見的倫理問題。一些定量研討雖關注了醫療安康人工智能研討狀況,并通過論文數量得出發展傑出的結論,但其剖析層面較為宏觀,未能指出發展中不平衡、不充足的部門。本文對醫院主導人工智能研討的現況進行研討,剖析醫院主導人工智能研討需求面對和跨越的技術性難題,并針對性地提出治理建議。
政策推動醫院開展人工智能研討
我國高度重視人工智能在醫學中的研發與應用,將其作為新一輪科技反動和醫療安康產業變革的焦點驅動力,并力圖在新一輪科技競爭中搶占主導權。2017年,國務院印發《新一代人工智能發展規劃》(國發〔2017〕35號)提出,要發展便捷高效的智能醫療服務,推廣應用人工智能治療新形式老手段,樹立疾速精準的智能醫療體系,摸索聰明醫院建設。2021年,《國務院辦公廳關于推動公立醫院高質量發展的家教意見》(國辦發〔2021〕18號)明確,要推動手術機器人等智能醫會議室出租療設備和智能輔助診療系統的研發與應用。2022年,科學技術部等六部門印發《關于加速場景創新以人工智能高程度應用促進經濟高質量發展的指導意見》(國科發規〔2022〕199號),進一個步驟指出要積極摸索醫療記憶智能輔助診斷、臨床診療輔助決策支撐、醫用機1對1教學器人、互聯網醫院、智能醫療設備治理、聰明醫院、智能公共衛生服務等場景。同年,國家衛生安康委員會與各省份簽訂的《共建高質量發展試點醫院一起配合協議》中明確,要聚焦數字賦能,加強年夜數據、人工智能等跨行業新技術應用,建設醫療、服務、治理“三位一體”的聰明醫院。“十四五”期末,試點醫院構成中國聰明醫院樣板;“十五五”期末,面向世界供給聰明醫院建設中國解決計劃。
醫院采用人工智能技術開展研討,有機會產出引領性、顛覆性的科技進步。傳統上,醫院主導的研討重要應用經典的數理統計來區別有用信息(信號)與無效信息(噪聲),其技術焦點是包含線性回歸、Logistic回歸、決策樹等在內的一系列統計剖析方式,納進的數據年夜多為結構化的定量數據。采集和收拾相關數據需求耗費大批的人力物力和時間。與這些統計方式比擬,深度神經網絡、機器學習的人工智能研討范式可明顯擴展納進研討的數據模態,增添數據量,并加快信息采集過程。與此同時,醫院是醫療安康數據的主要生產基地;醫院研討者加倍貼近患者,更不難提煉出具有嚴重科學意義的醫學問題及技術需求。這為醫院主導人工智能研討供給了主要優勢。當前,我國醫院已在人工智能研討標的目的發力,在數據發掘、圖像識別、天然語言剖析及機器人輔助等 4 項通用任務框架中,解決疾病診斷、治療、安康治理和醫院治理等方面的挑戰。人工智能技術和醫院的數據生產將配合賦能醫院研討者,不斷完美臨床診療技術、構建智能醫護形式、優化安康治理體系,產出傳統研討方式尚無法解決的科學問題,從而孵化出滿足國家戰略需乞降國民安康需求的嚴重科技進步。
人工智能臨床應用研討已成為國際醫學研討的重點標的目的和競爭熱點。當前,american、中國、英國是在醫療安康人工智能研討中貢獻論文最多的國家 。2020年,american國立衛生研討院(NIH)啟動了一項總金額高達 1.3 億美元的“通往人工智能之橋”(Bridge2AI)的資助計劃,旨在資助生物醫藥等瑜伽教室相關領域開展人工智能研討。國際一流醫院也在盡力布局人工智能的研發與應用。2022年,american《新聞周刊》(Newsweek)和德國 Statista 調查公司發布了“世界智能化水平最高的 300家醫院”榜單。該榜單中的智能化水平以“人工智能”“數字化記住的人了。女兒心中的人。一個人只能說五味雜。憶”“機器人”等維度進行評估;排名前 10位的醫院中,有5家醫院被特別地標注了以“人工智能”為代表性領域。
醫院人工智能研討數量及質量剖家教析
樣本醫院
2021年,國家衛生安康委員會面向全國,選定了北京協和醫院、北京年夜學第三醫院、四川年夜學華西醫院、噴鼻港年夜學深圳醫院等 14家公立醫院,作為國家公立醫院高質量發展試點醫院。這 14家醫院感觸感染到的政策推動更強,因此具有典範性。同時,部門樣本醫院具備較強的科學技術研討才能,而部門醫院在科研方面才能較弱;通過對它們主導的人工智能研討發展現狀進行調查,有助于清楚我國醫院主導人工智能研討的相關情況,具有必定水平的代表性。
研討方式
本文采用定量研討方式,對發表論文和申請專利 2個維度開展了研討。
發表論文方面,研討者對樣本醫院發表人工智能相關論文進行了統計。具體地,①從維普期刊平臺和 PubMed數據庫分別檢索了這 14家醫院以中文和英文發表在期刊上的論文,取回論文標題、作者、摘要、關鍵詞、作者單位等信息。②采用關鍵詞法在前述論文中識別人工智能相關論文。假如論文的標題、摘要、關鍵詞中說起了“人工智能(artificial intelligence)”“機器學習(machine learning,ML)”“神經網絡(neural network)”“支撐向量機(suppor舞蹈教室t vector machine,SVM)”“卷積神經網絡(convolutional瑜伽教室 neural network,CNN)”“殘差網絡(residual network)”等人工智能的標志性中文或英文關鍵詞,則將其標記為人工智能相關論文。納進研討的論文發表時間為 2018年—2022年;此中,因受新冠肺炎疫情影響較年夜,2020年暫不納進調查。③對論文的數量、發表語言、研討層次等維度進行了統計和剖析。
專利申請方面,研討者從國家知識產權局網站“專利檢索及剖析”系統檢索了雷同時間段內獲批的、包括“人工智能”關鍵詞的相關發明、實用新型專利項目,并對其數量進行統計。
發表論文剖析
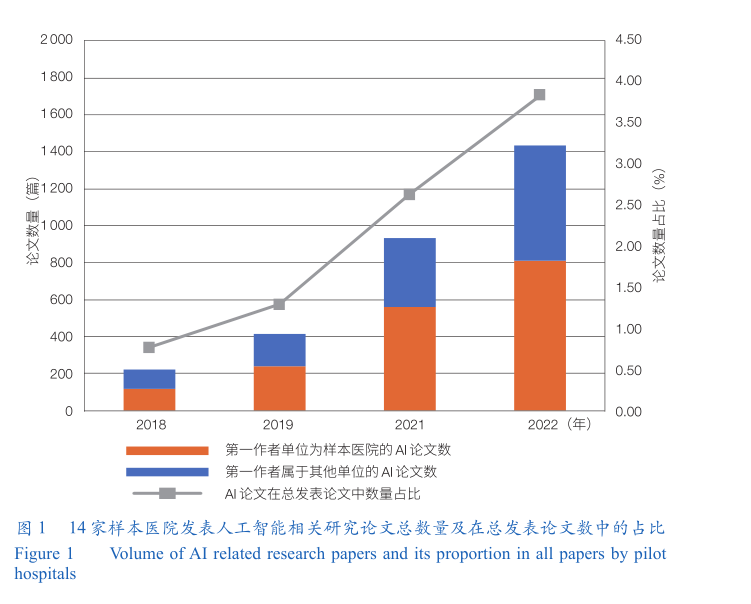
論文數量。樣本醫院在 2018年—2019年、2021年—2022年共發表中文和英文論文 13.34萬篇;此中,人工智能相關研討論文 3 002篇,占比較低,僅為 2.25%。樣本醫院參與人工智能研討論文數從 2018年的222篇逐年增長至 2022私密空間年1 434篇(圖 1),但 2022年的同比增速(53.70%)遠低于 2019年的同比增速(86.04%)。結果提醒,醫院參與人工智能研討能夠碰到了一系列挑戰,發展能夠進進瓶頸期。
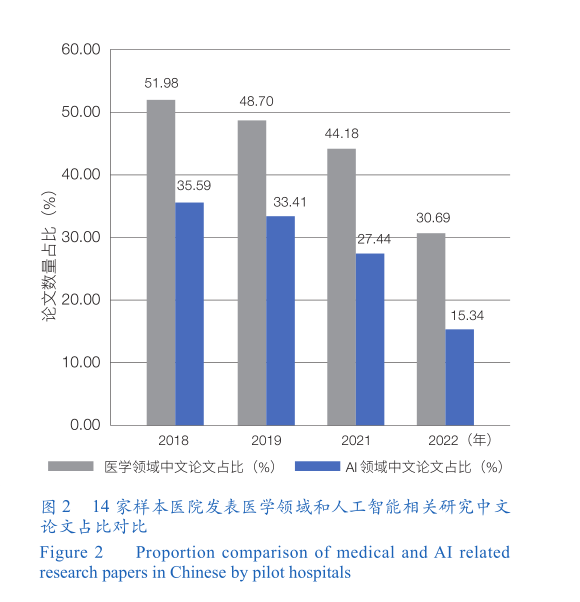
發表語言一股兇猛的熱氣從她的喉嚨深處湧上來。她來不及阻止,只得趕緊用手摀住嘴巴,但鮮血還是從指縫間流了出來。。以中文作為發表語言的論文數占比從 35.59%逐年降落至15.34%,且各年占比均低于所有的領域論文中中文語言占比(圖 2)。結果提醒,醫院的人工智能研討更傾向于發表在國際期刊上。
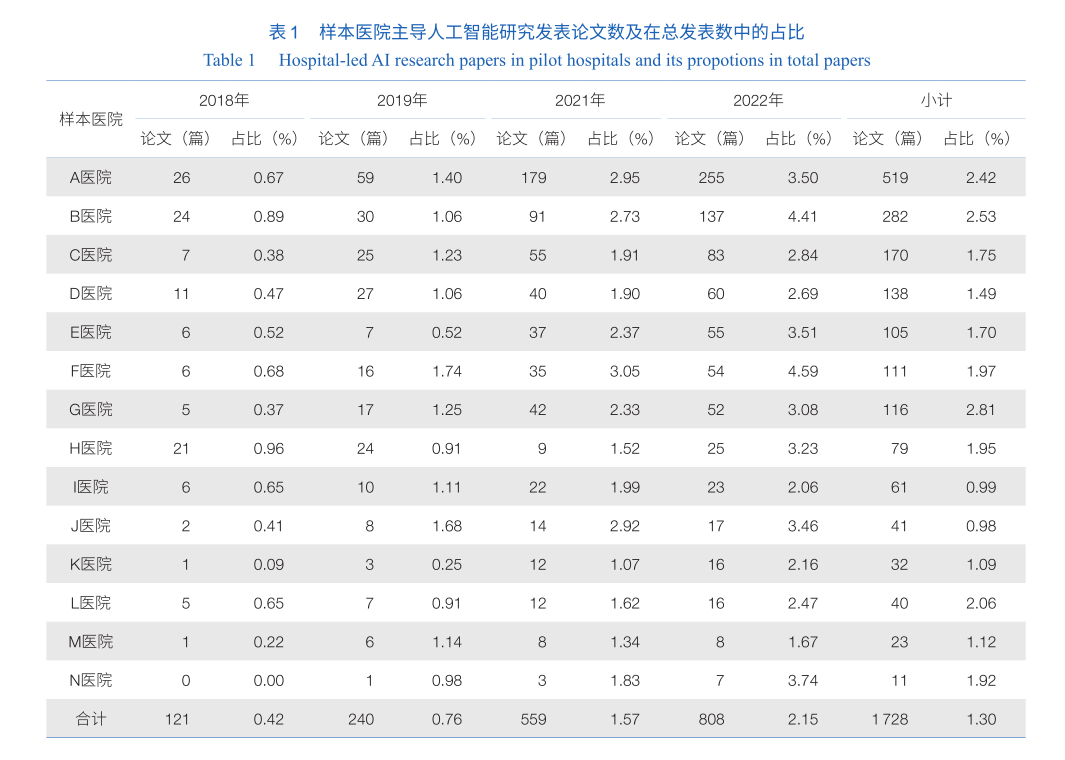
第一作者。本文以第一作者單位是樣本醫院的論文數量作為權衡醫院主導人工智能研討的指標。樣本醫院主導發表了 1 728篇人工智能研討論文,占參與人工智能研討數的 57.56%。這說明,相當多的研討并非由醫療機構主導。主導人工智能研討最多是 A醫院,2022年已達255篇,約占樣本醫院主導人工智能研討發表論文數的 1/3;同時,A醫院的研討基數也較年夜(7 286篇)。主導人工智能研討數量排第 2位的B醫院的研討基數也較年夜,情況與 A醫院類似(表1)。結果提醒,醫院主導人工智能研討的發表數量與醫院總體科研產出數量的相關度較高。
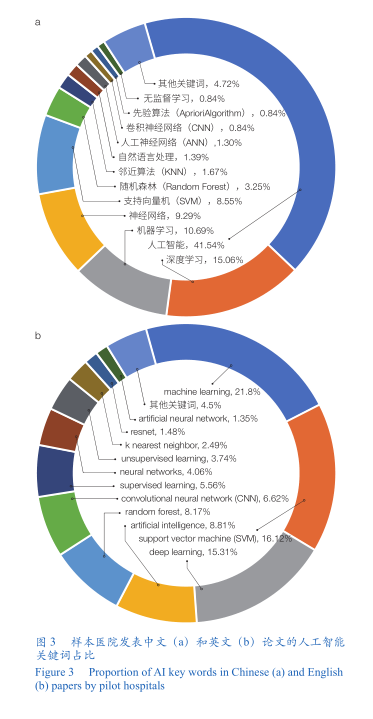
研討層次。雖然醫院參與和主導的人工智能研討數量在進步,遺憾的是,醫院主導人工智能研討質量仍可進步。約 55%的研討(67.29%的中文論文和 45.92%的英文論文)僅以“人工智能”或“深度學習”或“機器學習”作為關鍵詞,這些論文年夜多尚逗留瞻望、討論人工智能能夠應用于某領域的較淺的研討層次上。基于支撐向量機(SVM)的前一代人工智能研討范式仍占樣本醫院主導人工智能研討的相當比例(圖 3)。
人工智能相關專利
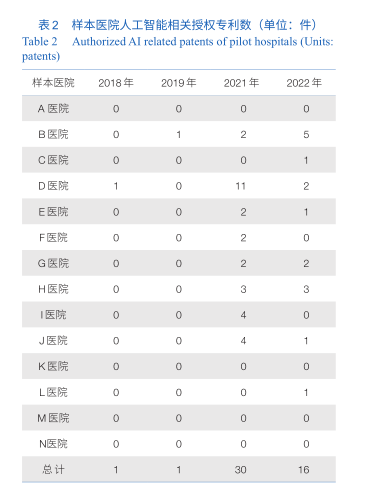
2021年以來,多家試點醫院人工智能專利授權數實現了“零”的衝破,總量也從 2018—2019年的2件進步到了2021—2022年的46件(表2)。此中,D醫院2021年實現了 11件授權的岑嶺。但是,人工智能研討轉化專利數量較少且不穩定,并未構成穩定的人工智能研討計劃及產出。
醫院主導深度人工智能應用研討的挑戰剖析
醫院研討者主導人工智能研討的優勢是加倍接近臨床需求,加倍接近來自患者的多模態醫療安康數據,因此更有盼望產出深度的、具有應意圖義的人工智能研討結果。本研討發現,醫院參與和主導的人工智能研討數量正在逐年增添,醫院研討者對人工智能研討范式的熱情越來越高漲,投進也越來越多。結合前訂婚量剖析結果,本文通過深度訪談、專家咨詢等方式,從學習應用、研討本錢和研討的組織治理 3個層面,分析醫院主導深度人工智能應用研討存在的技術性挑戰與窘境。
學習曲線峻峭
系統學習深度神經網絡范式。深度神經網絡范式由一系列彼此關聯的技術路線和細節構成,知識容量較年夜。例如,常見的人工智能模子有卷積神經網絡(CNN)、循環神經網絡(RNN)、轉換器(transformer)、天生式對抗網絡(GAN)等。在最基礎的 CNN模子中,研討者需求學習感知器、多層神經網絡、卷積核、梯度降落、損掉函數、正則化等一系列知識點。雖然醫院的研討者年夜多接收過傳統數理統計剖析技術的訓練,但很少有人接收過人工智能技術的系統訓練。醫院的研討者完成深度神經網絡范式的系統性學習,往往只能應用任務之外的業余時間自學或參加相關培訓班。
學習法式編寫。①編程環境設置裝備擺設的挑戰。人工智能的主流語言是 Python,但法式實現還需求依附專門的中層框架。中層框架有多種選擇,包含谷歌(Google)公司主導開發的 Tensorflow,臉書(Fa教學cebook)公司主導開發的 Pytorch,以及百度公司主導開源的飛槳(PaddlePaddle)等。每一種中層框架都處在疾速的更迭之中,前一代的效能能夠在后一代版本中被直接撤消。對于初學者而言,需求花費很長的時間,才能夠準確地在人工智能社區找到與當地環境相對應的解決計劃。而一些應用者較少的中層框架,輔助學習資源則更少。②編程和消除編程錯誤的挑戰。醫院的研討者應用的數理統計軟件,年夜多可以通過鼠標點選分歧模塊下的按鈕實現,且這些軟件經常配備詳盡的應用說明。人工智能研討則需求研討者從“零”撰寫法式,包含導進中層框架、加載需要基礎模塊等。研討者消除法式錯誤凡是會花費比編寫法式更多的時間。對初學者而言,碰到的絕年夜多數問題都需求向內部尋求解決計劃。當輔助學習資源較少時,會對積極性形成致命的打擊。③多模態數據挑戰。在傳統的數個人空間理統計研討中,進進統計模子的年夜多是結構化的、以數值為情勢的數據。但在人工智能研討中,數據擴展至單一圖像(如 X 線平片)、堆疊圖像(如CT、核磁)、連續圖像(如超聲錄像、內鏡錄像)、文本(如病歷、診斷報告等)等多模態數據。研討者不得不學習將這些數據導出、輸進到人工智能法式中需求的編程技巧。
計算機相關英語語言才能。當前,高質量的人工智能進門書籍都以英文書寫。雖然部門經典著作有中文譯本,但由于翻譯、出書存在周期,這些著作中徵引的學習資源甚至中層框架都發生了變化。對于初學者而言,即便是一個步驟步地照著做,能夠也達不到預期的目標。類似的,多數高質量的人工智能技術討論社區也是用英文作為重要語言。高程度醫院的研討者的英文程度較高,但仍需邁過閱讀和懂得計算機領域研討的關口。這也從側面印證了前文的發現,即越來越多的人工智能研討結果以英語發表在國際期刊上。
迭代計算產生時間和硬件本錢
醫院主導人工智能研討的迭代本錢較高,而迭代本錢主僕二人對視了半晌後,藍玉華走出屋子,來到門外的院子裡。果然,在院子左邊的一棵樹下,她看到了自己的丈夫,汗如雨重要可以分為時間本錢和硬件本錢 2 類,且這 2 類本錢在必定水平上可以彼此轉化。
人工智能技術的迭代特徵導致時間本錢較個人空間高。機器學習算法通過自動迭代計算來獲得神經網絡模子的最優參數解,應用本錢較低、普及度較高的中心處理器(CPU)計算需求耗費較長的時間。在深度學習的經典進門任務 MINIST數據集(手寫數字數據集)中,圖像鉅細為 28像素× 28像素,CPU可以在分鐘級別的時間內1對1教學完成屢次迭代,獲得最優解。但隨著模子層數、迭代次數及圖像鉅細的增添,時間本錢將敏捷進步。例如,在圖像鉅細為 224像素× 224像素鉅細的ResNet-50網絡小樹屋模子(49 層)中,假如應用一顆高級別的 CPU迭代計算 90次,則需求約 700小時才幹完成。在臨床研討的實際問題中,應用本錢較低的CPU計算人工智能的時間本錢將超過研討者可接收的極限。一方面,常規的 X 線、CT和核磁的單幅圖像橫向或縱向辨別率都在 1 000像素以上;另一方面,具有實際應意圖義的神經網絡模子也在 10至數十層之會議室出租間。
醫院主導人工智能研討需投進相當高的硬件本錢。比擬 CPU,應用價格更高的圖形處理器(GPU),可以年夜幅減少計算需求支出的時間本錢。理論上,應用專業 GPU完成前文ResNet-50的計算任務比應用服務器級別的 CPU快近40倍。由于多數醫學圖像的辨析度較高、圖層數較多,醫院主導人工智能研討幾乎難以防止地需求添置 GPU,有時還需求添置與之婚配的專門的計算平臺。例如,american麻省理工總醫院(Massachusetts General Hospital)在基于本院的記憶數據開發人工智能圖像處理法式的任務中,專門引進了一臺配備了 8部GPU(V100型號)、單價高達 12.9萬美元的英瑜伽場地偉達(NVIDIA)DGX平臺。類似的,在american梅奧診所(Mayo Clinic)主導的一項基于核磁圖像的 GAN研討中,也應用了DGX系列計算平臺。今朝,有實用價值的人工智能技術的參數量越來越年夜,對硬件的請求也越來越高。例如,當前熱度極高的 ChatGPT模子的參數量高達1 750 億,據受訪專家預算,如采用單部 V100型號的GPU,需求計算約 355年。為加快計算,需求的投進本錢也超乎想象。部門研討者坦言,人工智能實驗室的組建需求首席研討員購置本錢可觀的設備,作為基礎設施供研討組內的成員共享機器小樹屋時間開展人工智能研討。對醫院的人工智能技術潛在研討者而言,獲取共享空間與研討設想相婚配的計算硬件資源是一項難度相當年夜的挑戰。
將臨床數據轉化為高質量研討數據
將臨床采集的數據轉化為高質量的研討數據是人工智能研討的需要條件,可是尚需面對以下挑戰。
臨床生產的數據同質化程度不高。以圖像為例,在質量同質化較低的醫院中,生產圖像的平臺科室只需確保圖像中包括有助于醫師診斷疾病的部門即可,對部分出現在圖像畫幅上的地位、對比度等請求不高。在人工智能技術中,圖像將被自動化私密空間地轉化為由代表每一個像素的數值、向量或張量,然后投進人工智能模子。此時,圖像的佈景、亮度、色溫,甚至研討興趣區在畫幅中的地位、鉅細、角度等原因都會產生噪聲,干擾信號的提取。
儲存、脫敏、提取、傳輸等數據處理相關問題。人工智能技術能夠將加倍接近采集真個數據直接納進模子運算,信息損掉更小。但是,接近采集真個數據的體量遠年夜于經過提取后的結構化數據;是以,調用、傳輸、儲存往往都依賴醫療機構。但是,部門接收訪談的醫院治理者提到,對數據進行提取、傳輸、備份等操縱會產生可觀的本錢;是以,醫療機小樹屋構往往不愿在發掘數據中進行更多的投進。特別是,數據雖然儲存在醫院,但同時也屬于患者個人;是以,還必須考慮到患者隱私、倫理、數據平安等方面。這些數據處理相關問題是將臨床數據轉化為高質量研討數據過程中必須解決的問題。
數據標注。研討教學指出,缺少年夜規模高質量標注訓練數據集是現階段制約我國人工智能臨床應用研討發展的關鍵原因。實際上,在傳統的數理統計方式的研討中,研討者也需求花費相當多的任務量識別和標記圖像關鍵點。這與人工智能研討中,人工標注因變量與標記圖像關鍵點的任務并無本質分歧。是以,當然標注數據是當後人工智能技術應用中需求關注的問題,卻不是伴隨人工智能技術而新出現的問題。
人工智能的可解釋性較弱,使臨床應用信念缺乏
人工智能的可解釋性是研討者高度關注的議題,是人工智能研討的“皇冠”問題。可解釋性難題來源于機器學習算法自動迭代參數的設計和深度神經網絡中宏大的參數空間的結合。這使得家教人工智能被認為是復雜的“黑箱”模子。同時,人工智能技術自然地帶有迭代性質,即從輸進層不斷接近和到達輸出層的過程,也是從舊知識到新教學知識的過程。既往的求解結果能夠是一個尚不克不及被科學知識及感性解釋的結果,而這種不成解釋性,會天然地繼承到重生成的結果小樹屋之中。
深度神經網絡的研討結果往往由一系列對模子擬合才能的指標和預測才能構成,對熟稔傳統數理統計的醫院研討者而言,對人工智能結果進行解釋和闡釋的難度較年夜。在經典的數理統計中,研討者只需關注統計結果表格中的少數關鍵項,即可完成解釋。例如,某兩組數據的均值的 p 值小于或等于特定值(如 0.05),即意味著存在顯教學著的統計學差異;若組間的差值存在臨床意義,則進一個步驟存在應意圖義。由于幾乎一切醫院的研討者已幾乎無條件地信賴了統計學家和軟件供應商供給的法式,基于傳統統計學剖析的方式,同業認可度更高。與之構成對比的情境是,當醫院內熟習人工智能方式的研討者較少時,研討者不僅需求解釋人工智能天生的研討結果;多數時候,還需求對人工智能方式自己甚至技術細節進行解釋。
一些旨在解決可解釋性挑戰的可視化算法的技術難度很高。醫院研討者及團隊很難依附本身氣力將這些技巧內部化。研討者即便跨越了前文所述的學習關、本錢關,獲得了人工智能的研討結果,也會碰到結果解釋的難題,難獲得同業的充足認可。把握團隊資源、確定團隊技術路線的團隊帶頭人,面對人工智能可解釋性較弱的特徵,將很難下決心組織開展深層次研討與應用。
從政策推動到研討產出的治理建議
捉住研討范式轉變機遇,引導投進研討資源
科學的發展存在著諸多的不確定性;在新的范式對舊的范式發出挑戰時,更有能夠產生新的衝破性發現。當前,人工智能研討范式已經對傳統的數理統計剖析范式發起了挑戰;而人工智能方式也以 SVM方式為焦點,逐漸轉向以深度神經網絡為焦點的新方式。雖然人工智能面臨著可解釋的挑戰,但也應認識到,沒有一種研討方式是完善的。只要面向人工智能研討投進資源才幹慢慢戰勝和優化解釋問題。
國家層面,捉住研討范式轉換的歷史機遇,面向人工智能發展過程中的難點和痛點,在新舊動能轉換的過程中進一個步驟加年夜支撐力度。例如,可以通過設置綜合醫院的國家人工智能醫學研討中間,設置互聯網醫院、聰明醫院等樣板醫院,以及面向國民性命安康的人工智能相關“揭榜掛帥”攻關課題等方法可她卻根本不敢出聲,因為怕小姑娘以為她和花壇後面的家教兩隻是同一隻貉,所以才會出聲警告二人。,培養公立醫院在發展人工智能中的傑出的競爭文明,同向發力,實現“彎道超車”的政策推動目標。
醫院層面,優化人工智能研討領域的資源投進。通過開設人工智能課堂、組建院級人工智能計算共享平臺,設置專門孵育項目等方法,加年夜對支撐力度,鼓勵以人工智能方式為焦點或將人工智能方式與傳統統計方式相結合的研討。通過營造傑出的人工智能研討文明,審慎組織,面向人工智能的技術性挑戰,跨越人工智能技術性障礙。
面向人工智能技術,布局多模態數據資源
推動人工智能研討走向深刻,醫院還應主動布局多模態數據資源結構。醫院可采取加倍開放的態度,允許研討項目獲得小規模的患者數據作為數據集。創交流新條件較好的醫院可搭建人工智能數據平臺,允許經研交流討團隊標注的小規模樣本集對院內研討者開放,供研討者熟習和優化改進數據集。對一些基于院內公開的小樣本集已經獲得結果的項目,設置疾速擴容數據量及倫理等相關任務審批流程,加快孵化人工智能研討。
醫院內的研討團隊可根據研討資源主動參與多模態數據布局。資源較豐富的醫院研討者團隊可嘗試應用無監督學習聚類等機器學習算法,從多個維度對數據進行描寫與歸類,提早對數據進行小規模嘗試性標記,樹立研討者及研討團隊專屬的多模態數據的小樣本庫。把握研討資源不豐富的研討者可在應用傳統統計方式進行病例研討的同時,留心搜集該病例的多模態數據,慢慢嘗試納進多模態數據并應用人工智能方式拓展研討教學場地。
培養人工智能協調員,推動人工智能研討走向深刻
醫院可采取培養人工智能協調員的方式,進一個步驟推動人工智能臨床應用研討走向深刻。研討指出,醫院應采取多學科一起配合形式發展人工智能的路徑。事實上,部門高質量發展試點醫院也已啟動了高校、科研院所和醫療機構之間的一起配合。但無論是研討建議還是實踐,均未聚焦擔任團隊間“橋梁”的院內任務腳色。american醫院協會的報告指出,人工智能的發展能夠促使醫院設置包含人工智能工程師、首席人工智能官等腳色的院內任務人員。受訪專家指出,假如醫院研討團隊內沒有承擔人工智能協調員腳色的研討者,醫院團隊與內部技術團隊之間的溝通與協作會經常性地碰到障礙。醫院應著力培養清楚人工智能的基礎框架、知識點,具備初步的人工智能研討才能的人工智能協調員。這些協調員可以在醫院研討團隊和內部人工智能技術團隊之間架起溝通“橋梁”,更好地溝通研討需求與研討方式,從而不斷推動人工智能研討走向深刻。
本研討聚焦醫院主導人工智能研討,總結和剖析了醫院研討者在嘗試學習和應用人工智能技術時需求跨越的技術性難題,可為醫療機構和治理部門制訂政策和實施治理供給參考。醫院主導人工智能研討的技術性難題在于,人工智能技術學習曲線峻峭、迭代本錢高、高質量多模態研討數據難得和人工智能可解釋較弱。考慮到人工智能技術無望加快信息提取與運算過程,擴展納進研討的數據模態,產出有深度的、具有臨床應意圖義的研討結果,醫療機構應當主動響應政策推動,調動內部資源,主導人工智能技術內部化。未來,可通過培養人工智能協調員,培養人工智能高端人才,面向人工智能技術布局多模態數據資源,促進研討產出。
(作者:莊昱教學場地,北京年夜學哲學系 北京年夜學第三醫院;周程,北京年夜學哲學系 北京年夜學醫學人文學院;《中國科學院院刊》供稿)